
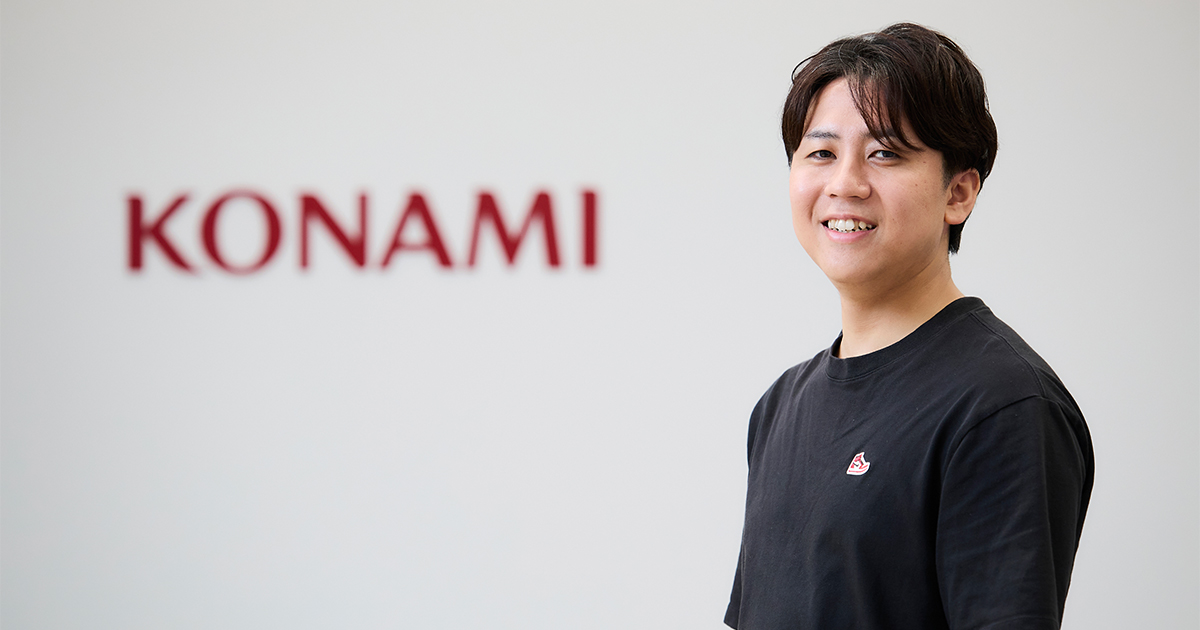
株式会社コナミデジタルエンタテインメント
制作支援本部 制作支援部 インフラ課
Y.Iさん
2014年4月に入社後、オンプレミスやベアメタル環境でのインフラ構築・運用に従事。現在は同社制作支援本部 制作支援部 インフラ課にて、モバイルゲーム領域を担当している
姉妹媒体『エンジニアtype』に掲載中の株式会社コナミデジタルエンタテインメントのインタビュー記事を転載しています。
企業のカルチャーや働く社員のイメージを知るためにご活用ください。
なお、募集職種とは異なる職種やテーマのインタビュー記事が掲載されている可能性もございますので、ご了承ください。
『eFootball™』『METAL GEAR SOLID』『遊戯王』などの世界的な人気タイトルシリーズから、『実況パワフルプロ野球』『プロ野球スピリッツ』『桃太郎電鉄』などの国内のメガヒットシリーズまで、数々のゲームを展開するKONAMI。
時に数百万DAU(Daily Active Users)を記録し、数十テラバイトのデータが行き交う膨大なトラフィックの裏側では、ユーザーのゲーム体験を守るための戦いが日々繰り広げられている。
「最も高性能なインフラ構成が、サービスにとっての正解とは限りません。巨大なゲームインフラの現場では、最適な技術を知っていること以上に、何を選び何を捨てるかを決める力が問われます」
そう語るのは、2014年からKONAMIのゲームインフラを支え続けている、制作支援部 インフラ課のY.Iさんだ。教科書通りの正解が通用しない世界で、KONAMIのインフラエンジニアはいかにして「捨てる決断」を下しているのだろうか。Iさんに話を聞いた。
株式会社コナミデジタルエンタテインメント
制作支援本部 制作支援部 インフラ課
Y.Iさん
2014年4月に入社後、オンプレミスやベアメタル環境でのインフラ構築・運用に従事。現在は同社制作支援本部 制作支援部 インフラ課にて、モバイルゲーム領域を担当している
目次
ーーKONAMIのゲームは世界中で遊ばれていますが、ピーク時に数百万DAUともなると、裏側のトラフィックは想像を絶する規模ですよね。
そうですね。一般的なWebサービスと比べても、ゲームインフラはトラフィックの変動が非常に激しいのが特徴です。
平常時のアクセス量に合わせてサーバーを用意していると、イベントやアップデートなどでアクセスが一気に跳ね上がった瞬間に処理しきれず、サービスが止まってしまう。かといって、常にピーク時に合わせた最大数のサーバーを稼働させれば、無駄なコストがかさみます。
そのため、どのタイミングでどれくらいアクセスが増えるのかを予測し、柔軟にサーバーを増減させる必要がある。安定性とコストのバランスを取りながら運用していくことが、ゲームインフラの大前提となります。
ーーモバイルゲームのトラフィックの特性は、タイトルごとに違うのでしょうか?
はい。一口にゲームと言っても、遊ばれ方によってトラフィックの性質はまったく異なりますし、それがインフラ構成にも直結します。
中でも、モバイルゲームは時間や場所を問わず遊ばれますし、イベント時などは短時間でアクセスが爆発的に増えることがある。そうした事情もあって、コンテナ、サーバーレス、仮想サーバーなど複数の技術の中から、その時々で適したものを選んで使い分けています。
さらにグローバル展開のタイトルとなると、「レイテンシー(通信遅延)」の問題をクリアしなければなりません。
ーー確かに、KONAMIのゲームは地球の裏側でもプレイされていますからね。
はい。例えば日本にしかサーバーがなければ、ヨーロッパからアクセスした際に物理的な距離の分だけレスポンスが遅くなります。ユーザーにとってゲームの「裏側の事情」は関係ありませんから、操作してから反応するまでに時間がかかれば「もっさりしたゲーム」だと感じ、ゲーム体験が損なわれてしまう。
じゃあユーザーの近く、世界中にサーバーを分散させればいいかというと、そう単純ではありません。拠点を増やせばデータベース間のデータ同期が必要になり、地理的距離によるレプリケーション遅延の問題や、膨大な運用コストが跳ね返ってきます。
レスポンスを改善しようとすると、今度はデータ同期やコストといった別の課題が生まれる。技術的に「最も高性能な構成」を作ることと、そのサービスにとって「最適なインフラ」を作ることは、必ずしも同じではないんです。
ーーだからこそ「何を選び何を捨てるか」を決める力が問われると。
例えばゲームの制作側から「対戦機能を付けたい」という要望があれば、求められるリアルタイム性や想定アクセス数、やり取りするデータ量をサーバープログラマーと一緒に整理します。その上で、クラウドサービスや構成案へ落とし込んでいく。
インフラエンジニアから「こちらならコストを抑えられる」「この構成ならレスポンスを速くできる」と提案することはあります。ただし、インフラ側だけで正解を決めるわけではありません。
開発のしやすさやゲームとしての優先順位も踏まえて、「何を取って、何を諦めるのか」をすり合わせる。そこの見極めが、インフラエンジニアの腕の見せ所だと思います。
ーー「何を諦めるか」という決断を迫られたケースで、Iさんが印象に残っているものは何でしょうか?
ピーク時には1日約500万人が遊ぶ、グローバル向けゲームのクラウド移行です。サーバーは数百台、データベースは数十テラバイトに及ぶ大規模なシステムでした。
そのゲームのデータベースは、もともとはベアメタル環境で動いていました。非常に高いI/O性能が求められており、NVMeを搭載した物理サーバー上でMariaDBを動かす構成が、必要なレスポンスを実現する上では合理的だったんです。
ただ、物理機器には寿命があります。メーカーの保守期限が切れる前に新しい機材へ移設しなければなりませんし、ハードウエアが故障すれば、深夜でもアラートが飛んできます。その度にデータセンターへ連絡し、部品交換などの対応をしなければならない。
数十テラバイトのデータを抱える環境を2〜3年ごとに移設する負担も大きく、「いつかはクラウドへ移さなければならない」と以前から考えていました。
ーーそれでも、なかなか移行できなかった?
長年動いている巨大なサービスですから、やはり怖さはありました。どうしても重い腰を上げられずにいたんです。
ところが、クリスマスやお正月といった重要な施策のタイミングで、機材トラブルによる障害が立て続けに発生してしまって……。そこでようやく「もう先延ばしにはできない」と腹をくくりました。
ただ、その時には機材の保守期限まで残り3カ月。先送りしてきた分、数百台のサーバーと数十テラバイト規模のデータベースを、わずか3カ月でクラウドへ移し切らなければならない状況になっていました。
ーー残り3カ月でその規模の移行となると、相当なプレッシャーですね。まず何から手を付けたのですか?
まず検討したのが、データベースの移行先です。
既存環境は「MariaDB」でしたが、せっかくクラウドへ移すなら、障害時のフェイルオーバーが速くストレージも自動拡張できる「Amazon Aurora MySQL」へ移したいと考えました。MariaDBはMySQL派生なのである程度の互換性があります。そこでサーバープログラマーとも相談し、Aurora MySQLへの移行を前提に検証を始めました。
ところが、実際にアプリケーションを動かすとエラーが続出したんです。長年運用する中で、JSONの扱いやクエリの書き方など、MariaDB固有の仕様に依存した処理が想像以上に積み重なっていました。
ーーそれを全て修正していては、3カ月では到底間に合いませんね。
今振り返ると、そこで私は「欲」を出してしまったんですよね。クラウドへ移すだけでなく、この機会にシステム自体をモダナイズしたかった。
でも、このプロジェクトの最優先事項は新しいアーキテクチャを採用することではなく、「3カ月以内に安全に移行を完了させること」です。そこに立ち返って、Auroraへの移行は諦め、既存環境と互換性の高い「Amazon RDS for MariaDB」へ方針を切り替えました。
技術者としては、より良いものや新しいものを使いたくなるものです。ただ、限られた期間で大きなリスクを伴うプロジェクトを進める時には、「何をやるか」だけではなく、「今は何をやらないか」を決めることも重要な技術判断なのだと学びました。
ーーAuroraを諦めて移行先を決めたことで、ようやく道筋が見えたのでしょうか?
いえ、次はデータそのものを「どう運ぶか」で苦戦したんです。数十テラバイトのデータをベアメタル環境からAWSへ移すため、当初はmysqldumpでデータを出力し、差分をレプリケーションする方法を試しました。
ところが、1日経っても、2日経っても一向に処理が終わらない。途中で通信が切れてやり直しになることもありました。
原因を調べると、mysqldumpは基本的にシングルスレッドで処理するため、巨大なデータをそのまま出力しようとすると膨大な時間がかかることが分かりました。クラウド側へのリストア処理も同様です。
ーー「正しいはずだった方法」が、規模の大きさゆえに通用しなかったと。
そこで、巨大なデータを細かく分割し、複数の回線を使って並列転送する方式へ変更しました。リストアも複数のCPUで並列化する。さらに、データ移行の期間だけRDSのスペックを最大まで引き上げ、一気にデータを流し込みました。
普段から最大スペックのサーバーを維持するのは、コスト的に現実的ではありません。でも、クラウドなら必要な期間だけリソースを増やせる。最初に考えた方法に固執するのではなく、「今どこが詰まっているのか」を見ながら、その都度やり方を変えていきました。
ーーそれでも、データベース以外に数百台のサーバー環境が残っています。
サーバーの移行は、かなりスムーズに進んだんです。以前から進めていた「IaC(Infrastructure as Code)」が大きかったですね。
もともとインフラ構成をコードで管理し、構成管理ツールを使ったミドルウエアのインストール自動化や、構築後の自動テスト基盤を整えていました。データベースの移行にはかなり時間を使いましたが、数百台あるサーバー環境自体の構築は3日ほどで完了したんです。
「人が一台ずつ作業しなくても、同じ状態を再現できる環境」を普段から作っていたことが、期限ぎりぎりの場面で役に立ってくれました。
トラブルが起きてから準備できることには限界があります。平時にどこまで自動化し、再現可能な状態を作っておけるかが、いざという時の対応力を決めると強く実感しました。
ーー限られた時間の中で取捨選択を繰り返したわけですが、時には突発的なトラブル対応にも迫られるのがインフラエンジニアですよね。
そういう意味では、ある大型イベントの開催期間中にDDoS攻撃を受けた時のことは強く記憶に残っています。
大会の重要な局面で、ロードバランサーに対するTCP SYNフラッド攻撃が発生し、このままではサービスエラーで大会が一時中断してしまう状況でした。
そこですぐさま制作チームと相談し、ロードバランサーの前段にCDNを置く構成へ切り替えたんです。グローバルに分散したエッジサーバーでトラフィックを受けることで、単一のロードバランサーへ集中していた攻撃の影響を吸収する狙いです。判断してから構成を切り替えるまで、1時間もかからなかったと思います。
ーー大型イベントの最中というプレッシャーの中で、なぜ即座に「CDNを挟む」と決断できたのでしょうか?
それまでの経験の蓄積があったからだと思います。これまでもグローバルコンテンツを運用する中で攻撃を受けたことはあり、その度周囲のエンジニアと「なぜ起きたのか」「どんな構成なら防げるのか」を議論し、試行錯誤を繰り返してきました。
今回のケースで大きかったのは、先ほどのクラウド移行でも触れた「IaC」による平時の備えです。DNSのTTLを平時から短く設定しておくことや、CDNを挟んだ際にアプリケーション側が正しいクライアントIPを認識できるようなヘッダー設定のルール群を、いつでも適用できるコードとして準備していました。
だからこそ、あの緊迫した状況でも「この方法ならいける」と判断し、実行に移せたのだと思います。
ーークラウド移行では「何を捨てるか」を決め、DDoSでは短時間で「何を選ぶか」を決めた。こうした正解のない状況での判断力は、どうやって身に付くのでしょうか?
個人的に、大規模なトラフィック環境に身を置くことこそが、インフラエンジニアの成長にとって一番重要だと感じています。
アーキテクチャの本を読んだり、クラウドの仕様を学んだりすることはもちろん大切です。でも、「この瞬間に判断しなければサービスが止まる」という本番環境では、それだけでは足りません。
大量のアクセスが来た時にどこが詰まるのか。障害時に何を最初に見るべきか。複数の選択肢から今どれを選ぶのか。そうした生きた判断力は、実際のトラフィックと向き合う中で磨かれていくのだと思います。
ーー実際に大規模なトラフィックと向き合い、地道に経験していくしかない。
もちろん、現場で積み重ねた経験を活かして、仮説と検証を行うことも欠かせません。
KONAMIには、これまで多くのタイトルを運営してきた実績があります。新しいゲームであれば、まず制作側が想定するDAUを参考に、過去タイトルの実績データから「この規模なら、これくらいのリソースが必要だろう」と仮説を立てます。
ただ、ゲームごとに機能も違えば、トラフィックの出方も違う。過去のデータがそのまま当てはまるとは限りません。
だから、ある程度構成が固まった段階で実際にアプリケーションを動かし、リリース前には負荷試験も行います。CPUやメモリの使用率、レスポンスを確認しながら、最終的なサイジングを詰めていく。机上では問題なく見えても、動かして初めて分かることはたくさんありますからね。

ーー経験があるから「分かる」のではなく、経験があるからこそ「まず確かめる」と。
過去の実績から仮説を立てて、実環境で確かめる。間違いがあれば修正する。この流れは、本番リリース後も変わりません。
CPUやメモリの利用率、APIのレスポンス、インフラコストなどを日常的に監視して、ユーザー数が落ち着けばサーバーを減らしたり、オートスケーリングを導入したりする。逆にイベントなどでトラフィックの傾向が変われば、また構成を見直します。
インフラの最適解は、一度決めたら終わりではありません。サービスが変わる以上、自分たちの判断も更新し続ける必要がありますね。
ーーここまで伺っていると、KONAMIのインフラエンジニアは単に「落ちない環境を守る人」ではないように感じます。
私がこの仕事に一番感じている面白さは、自分の技術的な決断が、そのまま世界中のユーザーのゲーム体験につながってることです。
インフラエンジニアの仕事は決して表から見えるものではありません。レスポンスが速いことも、イベント中にサービスが落ちないことも、世界の裏側でも同じ瞬間にゲームを楽しめることも、どれもユーザーにとっては「できて当たり前」です。
大型イベントでDDoS攻撃を受けた時も、ユーザーからすれば、裏側でどんな攻撃が起きていたのか、私たちが何をしていたのかは知る由もありません。
でも、それでいいんです。
何事もなかったように大会が再開して、世界中のユーザーがまたゲームを楽しんでいる。その光景を見て、「これがインフラエンジニアとしてゲーム体験をつくるということなんだ」と強く感じました。

ーー「ゲーム体験を守る」というより、そこで起きる熱狂まで含めて「つくっている」のですね。
私たちが判断を一つ間違えれば、レスポンスが遅くなるかもしれないし、大切なイベントでサービスが止まってしまうかもしれません。
一方で、正しい判断を積み重ねられれば、ユーザーは裏側のことを何も意識せず、ゲームそのものに没頭できる。
新しい技術を選ぶことが正しい時もあれば、あえて使わないことが正しい時もある。性能を優先する場面もあれば、コストや開発のしやすさを優先すべき場面もあります。
決まった答えがあるわけではありません。その時々で「今、何を選ぶべきか」を考え続け、「当たり前に遊べる環境」を泥臭くつくっていく。
その判断の積み重ねが、世界中のユーザーの熱狂につながっている。それが、KONAMIのインフラエンジニアが味わえる一番の醍醐味ですね。
撮影/赤松洋太 取材・文/今中康達(編集部)