三菱UFJインフォメーションテクノロジー株式会社
データエンジニアリング第二部 ※2026年11月時点
大垣幸司さん
2011年中途入社。前職のSIerを経て、入社後は約10年間、OSやミドルウェアなどのシステム基盤を担当。その後、ITコンサルティング部門での業務を経て、現部署へ異動。現在は、データプラットフォーム全体のアーキテクチャ設計・最適化を推進している
【PR】 NEW! ITニュース
個人約3300万人、法人約100万社。日本経済の基盤を担う三菱UFJフィナンシャル・グループ(以下、MUFG)のシステムには、途方もない量のデータが眠っている。
しかし、長年稼働し続けるメインフレームから最新のクラウド環境まで、1000を超えるシステムが複雑に絡み合うMUFGの環境下では、「データが存在すること」と「データが使えること」は全くの別問題だ。
システムごとにデータの形式や定義は異なるが、既存業務を止めて一斉にシステムを刷新するわけにはいかない。何を統一し、何を残すのか。その判断にも慎重さが求められる。
この難題に正面から向き合っているのが、三菱UFJインフォメーションテクノロジー(MUIT)のデータエンジニアたちだ。
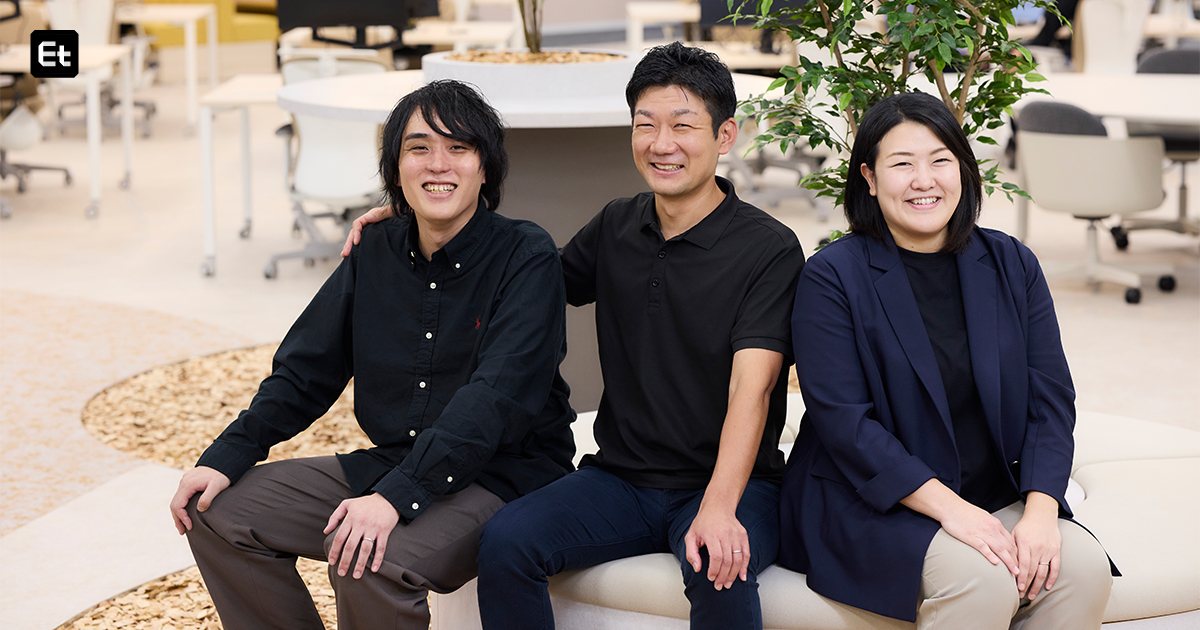
膨大かつ複雑なデータを、いかに信頼して使える「資産」へと変えていくのか。現場で変革を担う3名に、その実践と技術的な試行錯誤を聞いた。
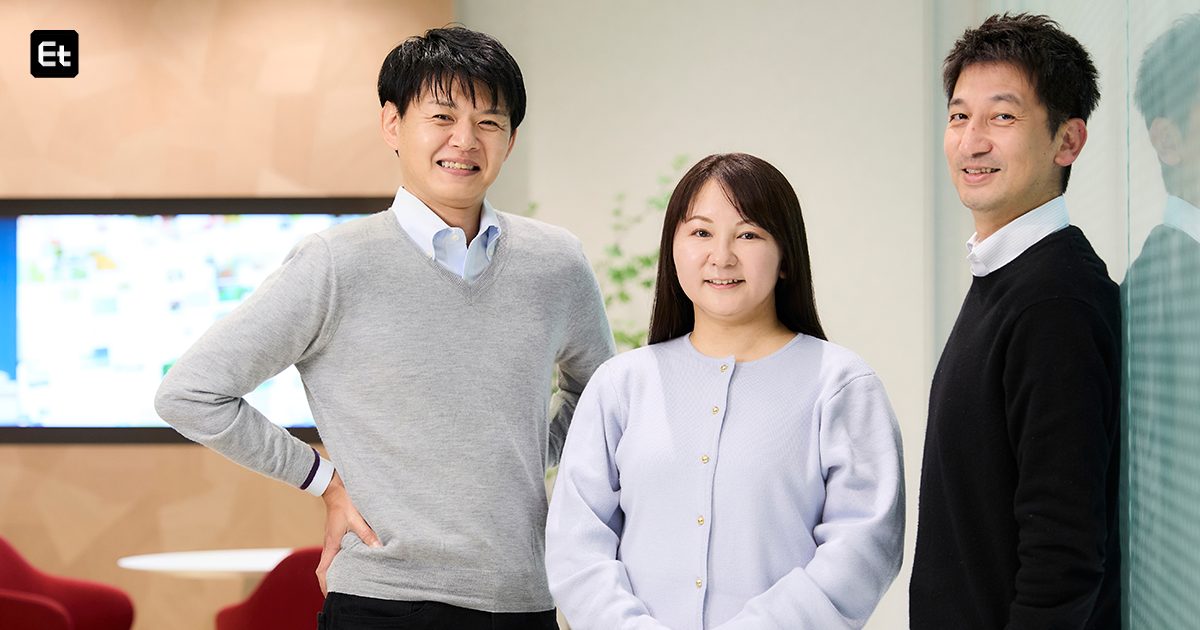
三菱UFJインフォメーションテクノロジー株式会社
データエンジニアリング第二部 ※2026年11月時点
大垣幸司さん
2011年中途入社。前職のSIerを経て、入社後は約10年間、OSやミドルウェアなどのシステム基盤を担当。その後、ITコンサルティング部門での業務を経て、現部署へ異動。現在は、データプラットフォーム全体のアーキテクチャ設計・最適化を推進している
三菱UFJインフォメーションテクノロジー株式会社
データエンジニアリング第一部 ※2026年11月時点
山守麻実さん
2007年新卒入社。預金・為替関連のシステムや顧客管理システムを担当した後、2020年末に現部署へ異動。現在は、MUFGのさまざまなシステムからのデータ収集・連携を担当し、収集プロセスの効率化や共通化にも取り組んでいる
三菱UFJインフォメーションテクノロジー株式会社
データエンジニアリング第一部 ※2026年11月時点
小林亮太さん
2015年新卒入社。入社後は情報系ホストや海外関連システムのDWH・データマート構築に従事。その後、ビッグデータ基盤の開発・保守を担当。現在は、データの加工・標準化やマスターデータの整備、データレイクハウスへの移行などに携わっている
ーーMUFGでは、以前から膨大なデータを蓄積し、さまざまな業務で活用してきたと思います。改めて今、「データマネジメント」の重要性が高まっている理由を教えてください。
大垣:従来は、DWHなどに集めたデータを、主に専門の担当者が分析していました。ただデータ活用が広がると、「同じ目的のデータなのに、担当者ごとに似た加工作業を繰り返している」といったロスが発生します。
加えて現在は、AIがデータを使うことでビジネスの競争力を生むことができますが、いちいち人間が「これはこういう意味です」と説明していては、本当の力を発揮できません。
そこで、データの収集能力を高めながら誰しもがデータを使い易いように加工し、AIに対しても毎回人間が指示や説明をすることなく、AI自身がデータを探索・理解しながら自律的に活用できる形への移行を目指しています。
ーーMUFGのように長い歴史を持つ大規模なシステム環境では、データを整備するのも一筋縄ではいかなさそうですね。
山守:MUFGには長年稼働しているメインフレームから最新のクラウド環境まで無数のシステムがあるのですが、それぞれが全く異なる業務目的に合わせて作られています。
そのため、各システムからデータを集めてきても、そのままでは使えないことが珍しくありません。
同じ名前のデータなのにシステムによって対象範囲や加工方法が違ったり、逆に別々のシステムにあるデータが、元をたどれば同じものだったりするんです。
特に長く稼働しているシステムほど、独自のルールや例外処理がブラックボックス化していて、当時の経緯を知る特定の担当者にしか分からないといったことも起きています。
ーー同じ名前のデータでも、システムによって中身が違う?
小林:例えば、同じ「顧客属性」という名前のデータでも、対象としているお客さまの範囲が違うことがあります。
社内のシステムで「顧客属性」と検索すると数多くのデータがヒットするのですが、あるデータは「融資先のお客さまだけ」を対象としている一方、別のデータには「全てのお客さま」が含まれているといった具合です。
他にも、特定のシステム向けに特殊な加工が施されていたり、同じような項目名でも意味や区分が微妙に違ったりします。これまで各業務に最適化してシステムを作ってきた結果、データがさまざまな場所に散在し、意味合いも少しずつズレてしまっているわけです。
利用する側がこの違いを知らずに使えば、意図しない結果を招きかねません。だからこそ、データの定義や作られた背景をきちんとひも解き、正しく解釈できる状態に整えることが重要なのです。
山守:ただ、こうした「データの差異」を調べるには、システムの担当者やデータオーナーに直接確認しながら一つずつ整理していくしかありません。
そのためデータの意味を整理する作業と並行して、データそのものを収集する仕組みの改善も進めています。
これまではシステムごとに個別のインターフェースを開発する必要があり、どうしても時間とコストがかかっていました。
現在は、データの収集方式を共通化し、個別開発なしで設定変更だけで対応できる仕組みや、AWS上のシステム同士なら直接データを受け渡せるようにするなど、収集工程を極力減らすアプローチも検討しているところです。
ーーでは、各システムから収集したデータを、どのようにして「使える状態」に整えていくのでしょうか。
小林:具体的な作業としては、収集したデータを加工・標準化し、全社で共通して使えるマスターデータを整備しています。
例えば、文字コードや日付形式、データ型をそろえたり、顧客番号や店番といった結合用のキーを桁数まで統一したりといったことですね。コードの意味がひと目で分かるように名称を付け直すこともあります。
もちろん、単に形式を合わせれば終わりではありません。異なるシステム由来でも同じ性質のデータなら統合し、同じシステム由来でも性質が違えば分ける。データの意味をしっかりと踏まえて正規化し、「まずこれを見ればいい」という共通の情報源をつくろうとしています。
ーー利用者によって欲しいデータの形は異なると思います。何を基準に、どこまで加工・標準化するかを決めるのが難しそうです。
小林:おっしゃる通りで、「基準日時点のデータで十分」「日次更新やリアルタイムに近いデータが欲しい」など、さまざまな要望があります。
しかし、そうした個別の要望に全て応えていると、結局その人専用のデータが増え続け、かえってサイロ化を招いてしまいます。
ですから私たちは、全員の個別要望に対して「100点」を取ることはあえて目指していません。まずは「何に使いたいのか」というユースケースを徹底的に聞き出し、他の業務でも共通して使える「60点から80点」の形を狙いにいくようにしているんです。
ーー個別最適に陥らないよう、共通基盤としての線引きを明確にしていると。
小林:そうですね。例えばデータの鮮度についても、共通基盤側では最低限の鮮度を担保するにとどめ、極度なリアルタイム性が求められる処理は別のパイプラインに切り出してもらうなど、基盤として責任を持つ範囲を明確にしています。
今後、AIの活用が広がれば求められるデータの形はさらに多様化するはずです。だからこそ、一人の利用者に寄り添いすぎず、全体の共通情報源としてどうあるべきかという設計思想を大切にしています。
ーーここまではデータの収集や標準化について伺いましたが、それらを支えるシステムアーキテクチャの改革も同時に進めているとか。
大垣:はい。メインフレームとクラウド環境に分散しているデータや機能を整理し、MUFG全体としてあるべき情報系アーキテクチャを構築するための改革を進めています。
というのも、長年のシステム運用の中で、メインフレームとクラウドの両方に同じデータが連携され、「二重管理」が発生してしまっているケースがありました。
具体的には、上流システムに変更が生じた際、それぞれの基盤で対応しなければならないといった状態です。アーキテクチャ全体を俯瞰し、こうした重複を解消していくことが今後の大きなテーマになっています。
ーーそうなると、既存のメインフレームにある機能をクラウドへ移行してしまうのが、手っ取り早いようにも思えます。
小林:全てを一度にクラウドへ移行するのは現実的ではありません。
例えば、メインフレーム上には管理会計業務を支えるシステムがあります。これは単にデータを蓄積・加工するだけでなく、専用のWeb UIを通じた業務とも密接に結び付いているため、データ基盤だけを新しくすれば済む話ではないんです。
そこで、こうした既存業務を支える仕組みは維持しながら、新しいデータ分析のニーズには、AWS上に構築したデータ基盤「OCEAN」を活用するというアプローチを取っています。
メインフレーム側のデータを新しい分析業務で使いたい場合も、既存の加工処理まで全て移植するのではなく、必要なデータをクラウド側へ連携する。そうすることで、既存業務への影響や移行コストを抑えています。
大垣:なお、見直しが必要なのはメインフレームだけではありません。クラウド上のデータ基盤も、技術の進化や利用ニーズの変化に合わせて進化させていく必要があります。
例えば、OCEANを構築した2019年頃は、データ関連の技術やサービスが今ほど充実しておらず、DWHを中心とした構成になっていました。
ところが、その後はBIの利用者や用途が増え、処理負荷やコスト、構成の複雑化が課題になってきました。さらにAIの普及によって、さまざまな仕組みから同じデータを利用したいというニーズも高まっています。
こうした変化に対応するため、DWH中心の構成から、データレイクハウス(DLH)中心の構成への転換も進めているんです。
ーー具体的には、どのような構成を目指しているのでしょうか。
大垣:特定のDWH製品の中にデータを閉じ込めるのではなく、オープンテーブルフォーマットを活用し、異なるコンピュートエンジンから同じデータを利用できる構成です。
これにより、利用する技術やサービスが変わっても、同じデータを柔軟に活用できる環境を目指しています。
もちろん、新しい技術を採用する際には機能や性能だけでなく、コストやセキュリティーも含めた判断が欠かせません。金融機関のデータを扱う以上、必要な関係部署とも連携しながら、慎重に検討を進めています。
メインフレームからクラウドへの移行も、クラウド基盤そのものの進化も、最新技術への置き換えが目的ではありません。既存の業務を支えながら、これからのデータ活用に適したアーキテクチャへと変えていくことが重要なんです。
ーーここまで伺ってきた取り組みの先に、どのようなデータ活用の姿を描いていますか?
大垣:私たちが目指しているのは、AI自身が必要なデータを発見し、その意味を理解した上で、安全かつ適切に活用できる環境です。
そのためには、データの品質や標準化、メタデータの整備、ガバナンス、アーキテクチャの最適化といったあらゆる取り組みが不可欠です。どれか一つを整えれば実現するというものではありません。
現在はデータの定義などをメタデータとして整理していますが、これだけではまだ不十分です。例えば、「このデータと別のデータがどう関係しているのか」「どういう業務で利用できるのか」といった意味や背景までAIが理解できるようにしなければなりません。
今後はセマンティクスやオントロジー、コンテキストといった領域の整備に加え、リアルタイムデータや非構造化データの活用にもさらに踏み込んでいく必要があると考えています。
ーー単にデータを一元管理するだけでなく、AIが文脈まで正しく解釈できる状態をつくる必要があると。
大垣:最終的には「Single Source of Truth(信頼できる唯一の情報源)」と呼ばれる世界を目指しています。
データそのものに加え、メタデータやオントロジー、コンテキストなどが適切に紐付き、誰もが共通の情報を参照できる。そうなれば、人によってデータの解釈や使い方がばらつくことも防げるはずです。
ただし、AIがあらゆるデータを自由に利用していいわけではありません。利用者や目的に応じたアクセス制御はもちろん、必要な場面では人間が判断に関与する仕組みも欠かせないと考えています。
ーー技術的な仕組みだけでなく、データが使われる先の「業務ドメイン」への深い理解も求められそうですね。
小林:おっしゃる通りで、私もマスターデータの整備に携わる中で、顧客情報など各業務に関する知識がかなり身に付きました。
データを日々扱っていると、「このシステムにはこういうデータの癖があるな」ということが見えてきます。そうすると、単に形式を統一するだけでなく、「ここをあらかじめクレンジングしておけば、利用者にとってもっと使いやすくなるはずだ」と一歩踏み込んで考えられるようになるんです。
山守:私もさまざまなシステムからデータを収集する過程で、金融業務への理解が深まっていると日々感じます。
やはり、そのデータが実際の業務でどう使われているのかを知らなければ、適切に管理することはできません。システムの担当者やデータオーナーと対話を重ね、背景をすり合わせることも、私たちの大切な仕事の一つです。
ーーデータエンジニアは個々のデータを整備するだけでなく、企業全体のシステムを俯瞰し、最適化していく役割も担っていると言えそうですね。
大垣:ええ。私たちは銀行内のさまざまなシステムからデータを受け取るため、組織全体のシステムやデータの流れを俯瞰できる立場にいます。
MUFGには1000〜2000ものシステムが存在します。これほど複雑で巨大な環境では、単に新しい製品やサービスを導入したからといって課題が解決するわけではありません。
技術はこれからも進化し、データの使われ方も変わり続けるでしょう。だからこそ、既存の仕組みを正しく理解し、その時々で「何を変え、何を残すべきなのか」を考え続ける必要があります。
よく銀行は「経済の血流」と言われますが、私はデータを「システムの血流」のようなものだと考えています。
データの流れが止まれば、さまざまなシステムや業務に影響が及んでしまう。だからこそ、データを必要なときに、必要な人やシステムが、適切な形で利用できる状態にしておくことが重要です。
そのために、今ある複雑な仕組みをどう変えていくのか。これからも向き合い続けなければならないテーマだと思っています。
撮影/赤松洋太 取材・文/今中康達(編集部)


タグ